
Диск под PostgreSQL заполнен на 90%. Один предлагает удалить старые данные, второй — запустить VACUUM FULL, третий — докинуть места. Всё это решения, а причина ещё неизвестна.
Высокая занятость диска — симптом, а не диагноз. Сначала нужно ответить на один вопрос: что именно занимает место? Ниже порядок, в котором я бы это выяснял.
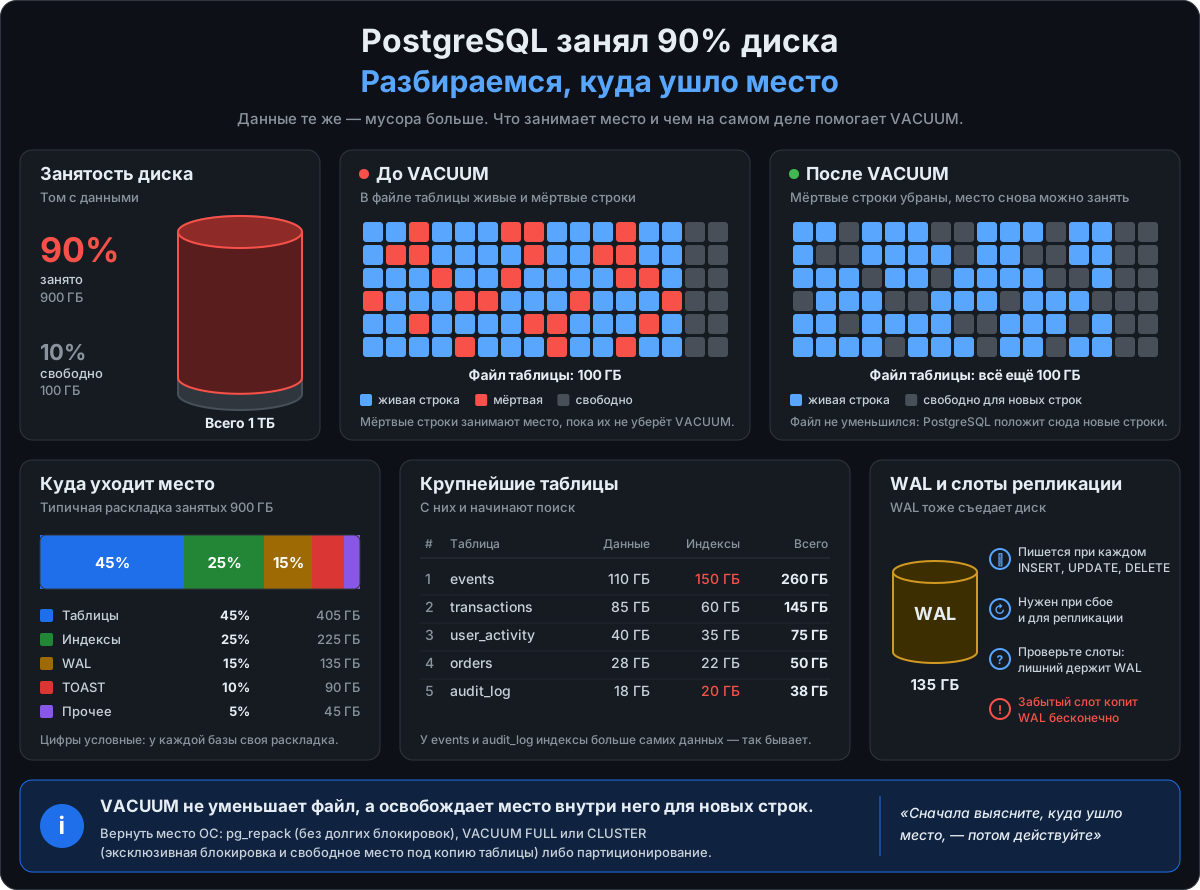
Поводом послужила статья PostgreSQL Storage Troubleshooting: The DBA’s 10-Minute Investigation Guide (Medium, 18 сентября 2026). Это мой разбор, а не перевод: часть запросов доработана, добавлено то, чего в оригинале нет. Инфографика — моя перерисовка иллюстрации из статьи на русском. В оригинале раскладка «куда уходит место» в сумме давала 1000 ГБ при занятых 900 — здесь доли пересчитаны.
Шаг 0. Что видит операционная система
Статьи о расследовании обычно начинают с SQL. Но если диск заполнен полностью, подключиться к базе может не получиться, а место может занимать вовсе не база. Поэтому сначала — уровень файловой системы:
df -h "$PGDATA"
du -sh "$PGDATA"/base "$PGDATA"/pg_wal "$PGDATA"/pg_replslot "$PGDATA"/log 2>/dev/null
du -sh "$PGDATA"/base/pgsql_tmp 2>/dev/nullЧто смотреть:
base— данные таблиц и индексов. Если растёт он, идём в шаги 1–4.pg_wal— журнал. Если он вырос до десятков гигабайт — сразу в шаг 5.log— логи самого PostgreSQL (путь задаётlog_directory). Включённоеlog_statement = 'all'или забытая ротация способны заполнить диск быстрее любых таблиц.pgsql_tmp— временные файлы сортировок и хешей. Один тяжёлый запрос легко занимает здесь десятки гигабайт.- Табличные пространства лежат отдельно, в
pg_tblspc, и могут быть на других томах.
Шаг 1. Какая база растёт
SELECT datname,
       pg_size_pretty(pg_database_size(datname)) AS size
FROM pg_database
ORDER BY pg_database_size(datname) DESC;Разовый снимок полезен, но настоящую картину даёт только динамика. Если размер баз не собирается в мониторинг, начните собирать — без этого не отличить штатный рост от сбежавшего процесса.
Шаг 2. Какие таблицы самые большие
pg_total_relation_size в одной цифре смешивает данные, индексы и TOAST. Для диагностики полезнее увидеть их раздельно:
SELECT c.oid::regclass                                  AS "table",
       pg_size_pretty(pg_relation_size(c.oid))          AS data,
       pg_size_pretty(pg_indexes_size(c.oid))           AS indexes,
       pg_size_pretty(pg_table_size(c.oid)
                      - pg_relation_size(c.oid))        AS toast_etc,
       pg_size_pretty(pg_total_relation_size(c.oid))    AS total
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE c.relkind IN ('r', 'm')
  AND n.nspname NOT IN ('pg_catalog', 'information_schema')
ORDER BY pg_total_relation_size(c.oid) DESC
LIMIT 20;Колонка toast_etc — это TOAST (вынесенные длинные значения: большие text, jsonb, bytea) плюс служебные карты свободного места и видимости. Если она сравнима с данными или больше их — место съедают крупные значения, а не число строк.
Секционированные таблицы покажутся по секциям: у родительской таблицы собственного размера нет. Суммарный размер секционированной таблицы считается через pg_partition_tree.
Шаг 3. Мёртвые строки и раздувание
Здесь главная неточность в популярных чек-листах, включая исходную статью. Обычно предлагают смотреть на число мёртвых строк:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       round(100.0 * n_dead_tup / nullif(n_live_tup + n_dead_tup, 0), 1) AS dead_pct,
       last_autovacuum
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;Запрос полезный, но он показывает не раздувание. n_dead_tup — оценка по статистике, и после VACUUM она падает почти до нуля. Файл таблицы при этом не уменьшается: место, которое занимали мёртвые строки, становится свободным внутри файла. Именно это и показывает инфографика: до и после VACUUM файл весит одинаково.
Получается, что таблица может занимать 100 ГБ при 30 ГБ живых данных, а n_dead_tup будет показывать ноль. Чтобы увидеть реальную долю свободного места, нужно расширение pgstattuple:
CREATE EXTENSION IF NOT EXISTS pgstattuple;

SELECT table_len,
       approx_tuple_percent,
       dead_tuple_percent,
       approx_free_percent
FROM pgstattuple_approx('public.events');approx_free_percent — доля пустого места в файле. Для индексов есть pgstatindex(): низкая avg_leaf_density означает раздутое B-дерево. Обе функции читают данные с диска, поэтому на больших таблицах их лучше запускать вне пиковой нагрузки.
Если мёртвых строк много и они не убираются, причина почти всегда в одном: что-то не даёт VACUUM их удалить. Это шаг 6.
Шаг 4. Индексы
SELECT schemaname,
       relname,
       indexrelname,
       idx_scan,
       pg_size_pretty(pg_relation_size(indexrelid)) AS size
FROM pg_stat_user_indexes
ORDER BY pg_relation_size(indexrelid) DESC
LIMIT 20;Колонка idx_scan показывает, сколько раз индекс использовался. Ноль у большого индекса — кандидат на удаление, но с тремя проверками:
- Статистика ведётся на каждом сервере отдельно. Индекс, которым не пользуются на primary, может обслуживать отчёты на реплике. Смотрите на всех узлах.
- Счётчик мог сброситься. Время сброса — в
stats_resetпредставленияpg_stat_database. Начиная с PostgreSQL 16 есть ещё колонкаlast_idx_scan. - Индексы под первичные ключи и уникальные ограничения удалять нельзя, даже если по ним не ищут: они обеспечивают целостность.
Шаг 5. WAL
SELECT pg_size_pretty(coalesce(sum(size), 0)) AS wal_size
FROM pg_ls_waldir();Нужны права суперпользователя или роль pg_monitor.
WAL размером до max_wal_size между чекпоинтами — норма. Если он заметно больше, PostgreSQL что-то держит. Причин три.
Слот репликации. Неактивный слот не даёт удалять WAL, который ещё не забрал его потребитель. Запрос показывает, сколько держит каждый слот (выполнять на primary):
SELECT slot_name,
       slot_type,
       active,
       wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots
ORDER BY pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) DESC NULLS LAST;Слот с active = false и растущим retained_wal — самая частая причина разросшегося pg_wal. Защита на будущее — параметр max_slot_wal_keep_size (PostgreSQL 13+): при превышении слот инвалидируется, и диск не заполняется. Цена — потребителя слота придётся переинициализировать.
Архивирование. Если archive_command падает, PostgreSQL копит WAL, пока сегменты не будут заархивированы:
SELECT archived_count, failed_count, last_failed_wal, last_failed_time
FROM pg_stat_archiver;Растущий failed_count — значит, архивирование сломано, а WAL копится.
wal_keep_size. Если параметр выставлен большим, PostgreSQL держит столько WAL всегда. Это осознанная настройка, но о ней стоит помнить.
Про долгие транзакции: исходная статья утверждает, что они мешают удалять WAL. Само по себе это неверно — WAL удаляется по чекпоинтам, и открытая транзакция его не держит. Исключение — логический слот репликации: его restart_lsn не продвинется дальше начала самой старой транзакции, и тогда долгая транзакция действительно копит WAL.
Шаг 6. Кто не даёт VACUUM работать
Мёртвые строки удаляются только тогда, когда их не может увидеть ни одна транзакция. Самая старая «точка зрения» в системе называется горизонтом xmin, и держать его могут три вещи. Исходная статья упоминает только первую.
Долгие транзакции, особенно idle in transaction — приложение открыло транзакцию и забыло её закрыть:
SELECT pid,
       usename,
       state,
       backend_xmin,
       now() - xact_start AS xact_age,
       left(query, 60)    AS query
FROM pg_stat_activity
WHERE backend_xmin IS NOT NULL
ORDER BY age(backend_xmin) DESC
LIMIT 10;Забытые подготовленные транзакции — после PREPARE TRANSACTION, которую так и не завершили. Они переживают перезапуск сервера и держат горизонт бесконечно:
SELECT gid, prepared, owner, database
FROM pg_prepared_xacts
ORDER BY prepared;Слоты репликации — через xmin и catalog_xmin, а также реплики с hot_standby_feedback = on, на которых выполняются долгие запросы:
SELECT slot_name, xmin, catalog_xmin
FROM pg_replication_slots
WHERE xmin IS NOT NULL OR catalog_xmin IS NOT NULL;Пока горизонт держится, autovacuum работает впустую, а таблицы раздуваются. В PostgreSQL 19 очередь autovacuum станет приоритетной, и посмотреть, какие таблицы он обработает первыми, можно будет через pg_stat_autovacuum_scores — подробнее о новых представлениях.
Шаг 7. Временные файлы и логи
Две причины, которых нет в исходной статье, хотя заполняют диск они регулярно.
Временные файлы. Сортировка или хеш, не поместившиеся в work_mem, уходят на диск. Сколько временных файлов создано с момента сброса статистики:
SELECT datname, temp_files, pg_size_pretty(temp_bytes) AS temp_size
FROM pg_stat_database
ORDER BY temp_bytes DESC;Текущие временные файлы показывает pg_ls_tmpdir(). Чтобы найти запросы-виновники, включите log_temp_files = 0 — каждое создание временного файла попадёт в лог вместе с запросом.
Логи. Размер каталога логов — pg_ls_logdir(). Логирование всех запросов или отсутствие ротации заполняет диск незаметно.
Пять действий, которые делают хуже
1. «Удалим старые данные»
Помимо очевидного риска удалить нужное, у DELETE есть техническая проблема: он не освобождает диск. Удалённые строки становятся мёртвыми, файл таблицы остаётся того же размера, а сама операция пишет WAL. При заполненном диске массовый DELETE увеличивает занятость.
Если данные действительно пора убрать, место освобождают TRUNCATE или DROP/DETACH секции — именно поэтому большие таблицы с данными по времени стоит секционировать заранее (подробнее — в разборе записи).
2. «Запустим VACUUM FULL»
VACUUM FULL переписывает таблицу в новый файл и действительно возвращает место операционной системе. Но:
- он берёт эксклюзивную блокировку: таблица недоступна ни на чтение, ни на запись до конца операции;
- ему нужно свободное место под новую копию таблицы и её индексов. На диске, заполненном на 90%,
VACUUM FULLкрупной таблицы может закончиться ошибкойNo space left on device— после нескольких часов работы.
Альтернатива для продакшена — pg_repack: он перестраивает таблицу без долгих блокировок, хотя место под копию нужно и ему. В PostgreSQL 19 готовилась встроенная команда REPACK, но она оказалась в списке фич под вопросом.
Уточнение к расхожей фразе «VACUUM не уменьшает файл»: обычный VACUUM всё-таки может отдать ОС пустые страницы в конце файла. Но мёртвое место в середине он только помечает свободным.
3. «Удалим самый большой индекс»
Большой индекс не обязательно лишний: он может обслуживать критичный запрос и избавлять от полного сканирования. Сначала проверьте idx_scan на всех узлах — шаг 4.
4. «Почистим pg_wal руками»
Никогда не удаляйте файлы из pg_wal. Это прямой путь к базе, которая не запустится, и к сломанной репликации.
Правильный порядок: найти, кто держит WAL (шаг 5), убрать причину — удалить ненужный слот через pg_drop_replication_slot() или починить архивирование, — и выполнить CHECKPOINT. Лишние сегменты PostgreSQL удалит сам.
Если диск заполнен на 100% и PostgreSQL уже упал, места не хватит даже на запуск. Освобождайте место вне pg_wal — старые логи, посторонние файлы на томе — или расширяйте том, затем запускайте базу и устраняйте причину.
5. «Добавим места и забудем»
Расширение диска — нормальная временная мера. В Kubernetes это расширение PVC, если StorageClass разрешает allowVolumeExpansion (о томах в задаче про StatefulSet). Но оно не отвечает на вопрос, почему место кончилось, — и через неделю ситуация повторится.
Чтобы до этого не доходило
- Алерт на 80%, а не на 95%. Плюс прогноз заполнения по скорости роста: «через 6 часов диск кончится» полезнее, чем «занято 81%».
- Мониторинг слотов:
retained_walпо каждому слоту иactive = falseдольше нескольких минут. max_slot_wal_keep_size— потолок, чтобы один забытый слот не положил primary.idle_in_transaction_session_timeout— автоматическое закрытие забытых транзакций.- Отдельный том под WAL. Если журнал заполнит свой том, это не съест место под данные, и наоборот. В CloudNativePG это
walStorage— подробнее в Рецепте 6.
Порядок расследования
dfиduпо каталогамPGDATA: данные, WAL, логи или временные файлы?- Если данные — какие базы и таблицы растут, отдельно данные, индексы и TOAST.
- Раздувание через
pgstattuple, а не толькоn_dead_tup. - Если WAL — слоты, архивирование,
wal_keep_size. - Кто держит горизонт xmin: долгие и подготовленные транзакции, слоты, реплики.
- Только после этого — действие, и в первую очередь то, что не требует блокировок и свободного места.
Сначала измерить, потом действовать: это быстрее, чем кажется, и почти всегда быстрее, чем исправлять последствия поспешного VACUUM FULL.